独立站 GEO/SEO 基建实战:Bing、Clarity 与 llms.txt 的真实取舍
type
status
date
slug
summary
tags
category
icon
password
wechat_gate
独立站 GEO/SEO 怎么做?答案不是先写一份
llms.txt,而是依次解决四件事:公开页面能被正确抓取,新增内容能进入搜索索引,引用与访问能被测量,接入分析工具后仍然符合隐私承诺。llms.txt、Markdown 镜像和第三方目录只能补充这条链,不能替代它。这篇文章记录我给 App Store 截图工具 ShotQuill 补 GEO/SEO 基建时的真实判断。技术栈是 Next.js 16 App Router 与 Vercel。过程中出现过一次错误警报、一次“链路成功但后台没数据”的反直觉现象,还发现分析 SDK 上线后,原来的隐私政策已经变成了错误陈述。
独立站 GEO/SEO 怎么做:先解决四层基础
GEO 是让内容更容易进入生成式答案的发现、检索与引用流程;它不是一套脱离 SEO 的神秘排名技术。对独立站来说,可靠的执行顺序是:可抓取、可索引、可测量、可合规。
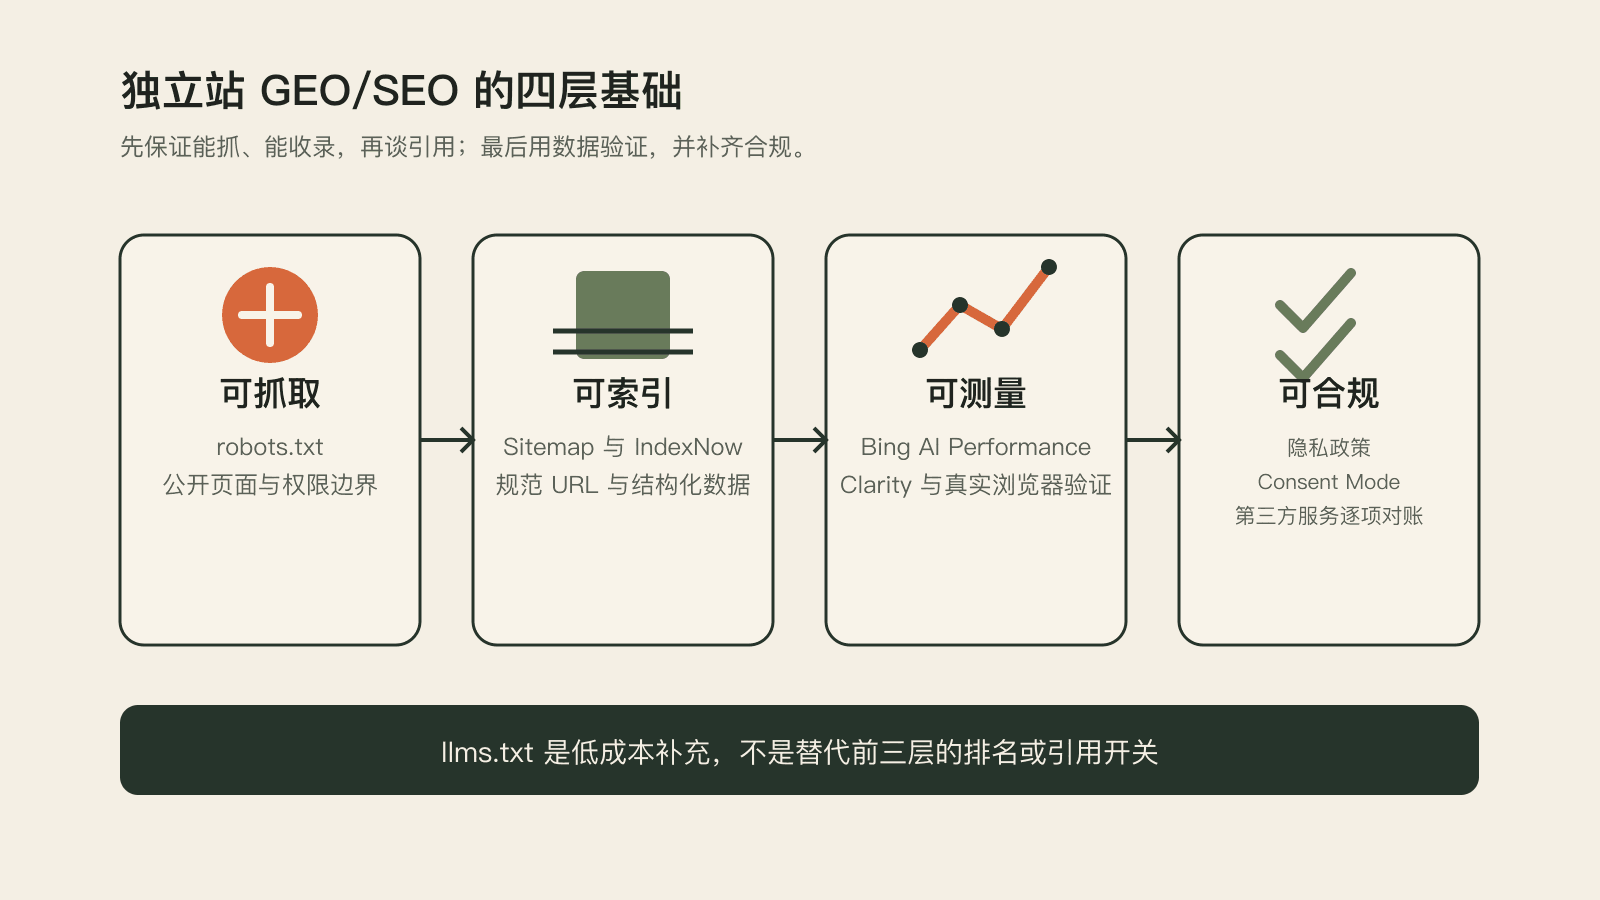
四层分别解决不同问题:
- 可抓取:
robots.txt是否允许目标爬虫访问公开页面,同时挡住登录态和产品内页。
- 可索引:Sitemap、规范 URL、结构化数据与 IndexNow 是否让搜索引擎及时发现正确版本。
- 可测量:Bing Webmaster Tools、AI Performance 和 Clarity 是否能提供引用、访问与行为证据。
- 可合规:分析 Cookie、会话回放、AI 服务商与支付服务商是否被准确披露,用户同意是否真的传递给 SDK。
这四层存在依赖关系。页面没被抓取,讨论引用率没有意义;页面进了索引但没有可引用的事实,模型也没有理由采用;装了分析工具却不验证网络请求,看到的可能只是一段从未执行的配置;技术链路通了但隐私政策仍写着“只使用必要 Cookie”,又会制造新的风险。
第一原理:降低发现与引用成本,而不是寻找 GEO 开关
独立站 GEO/SEO 的第一原理,是减少搜索系统从“发现页面”到“判断能否引用”之间的不确定性。
搜索与生成式回答都要完成一条相似的数据链:发现 URL、允许抓取、解析内容、识别实体与页面关系、判断内容质量与时效,最后才可能索引或引用。站长能控制的是输入条件,不能控制最终排名和答案选择。
因此,每个动作都应该对应一个可验证的约束:
动作 | 降低的成本或不确定性 | 不能保证什么 |
Sitemap | 发现站点内规范 URL | 不保证收录与排名 |
IndexNow | 及时通知 URL 新增、更新或删除 | 不保证页面被采用 |
robots.txt | 明确允许或禁止抓取范围 | 不负责内容质量判断 |
JSON-LD | 以机器可读方式表达实体与属性 | 不自动获得富媒体结果 |
llms.txt | 给愿意读取它的工具提供低噪声入口 | 不保证主流引擎读取、排名或引用 |
第三方提及 | 给品牌实体增加独立来源 | 不代表提及越多就一定被推荐 |
Google 在 2026 年发布的生成式搜索优化指南明确把基础 SEO、独特且对人有帮助的内容放在核心位置,并提醒站长不要把
llms.txt 等 AI 专用文件当成必要技巧。Bing 则把 Sitemap、IndexNow 与 AI Performance 放在同一条可观测链路里。两家的表述不同,但共同点很清楚:先把可发现、可理解、可验证的基础做好,再谈 GEO 增量。Bing 实战:从 GSC 导入,但先确认属性类型
已经在 Google Search Console 验证过站点时,从 GSC 导入 Bing Webmaster Tools 是最短路径:它省掉重复验证,并能带入已提交的 Sitemap。最容易出错的地方不是按钮,而是属性类型。
- Domain property 通过 DNS 验证,覆盖主域及其子域。
- URL-prefix property 只覆盖指定协议与前缀,
https://example.com和https://www.example.com是两条不同属性。
如果导入错了前缀,控制台可能显示“验证成功”,但长期没有实际数据。验证状态正确不等于监测范围正确。
ShotQuill 还经历过从
storepilot.link 到 shotquill.com 的域名迁移。这里的决定是保留 Bing 中的旧域属性,不急着删除。旧属性是观察 301 识别与迁移变化的窗口;删掉之后,问题发生时反而少了一层证据。导入后需要检查三项:
- Sitemap 是否指向当前主域,并返回
200。
- 规范 URL 与旧域重定向是否一致。
- IndexNow 是否在页面发布、更新或删除时发送通知。
IndexNow 的作用是“通知内容变化”,不是“几小时内必然收录”。Microsoft 的官方表述是帮助搜索与 AI 体验及时发现更新,而不是给出确定收录时限。把“主动通知”写成“保证几小时收录”,会把机制夸大成结果承诺。
2026 年 Bing Webmaster Tools 的 AI Performance 公开预览还提供总引用次数、被引用页面、grounding queries 样本与趋势数据。它测量的是被支持的 Microsoft AI 场景引用情况,不代表全网 GEO 排名,也不等同于页面权威度。
Next.js 安装 Clarity:只让生产环境上报
Clarity 的正确接入方式,是用环境变量限制生产环境,再交给
next/script 延迟加载。这样能避免本地开发与 Vercel Preview 会话污染真实数据。在
src/app/layout.tsx 中读取 Project ID:配套的示例环境变量也应该进入版本库:
这里踩到一个与 Clarity 无关、却很典型的坑:项目的
.gitignore 使用了 .env*,连 .env.local.example 也一起忽略。示例文件不进版本库,新环境就不知道需要哪些变量。修复方法是为它添加例外:判断安装成功不能只看页面源代码中是否存在
ms-clarity。最小验收标准是:生产环境存在 Project ID,浏览器加载 Clarity 脚本,collect 请求返回 2xx,并且 Cookie 行为符合当前 Consent 设置。一次错误警报:为什么 curl | grep 会骗你
我第一次验证部署时,抓到的首页只有 201 字节。这个结果很像部署失败,但它只是一次偶发的传输异常。
改为跟随重定向、启用压缩并连续请求三次后,结果稳定在约 50 KB,页面中也能找到 Clarity Script 配置:
这次错误警报留下两个可复用的判断:
- 单次网络请求出现异常时,重复结果之前不要把它当成部署事实。
grep -c统计匹配行数,压缩 HTML 常常只有一行;统计出现次数应使用grep -o ... | wc -l。
更关键的问题是:即使 HTML 中出现了脚本字符串,也只证明 React 输出里存在配置,不能证明 hydration、CSP、脚本下载和数据上报都成功。
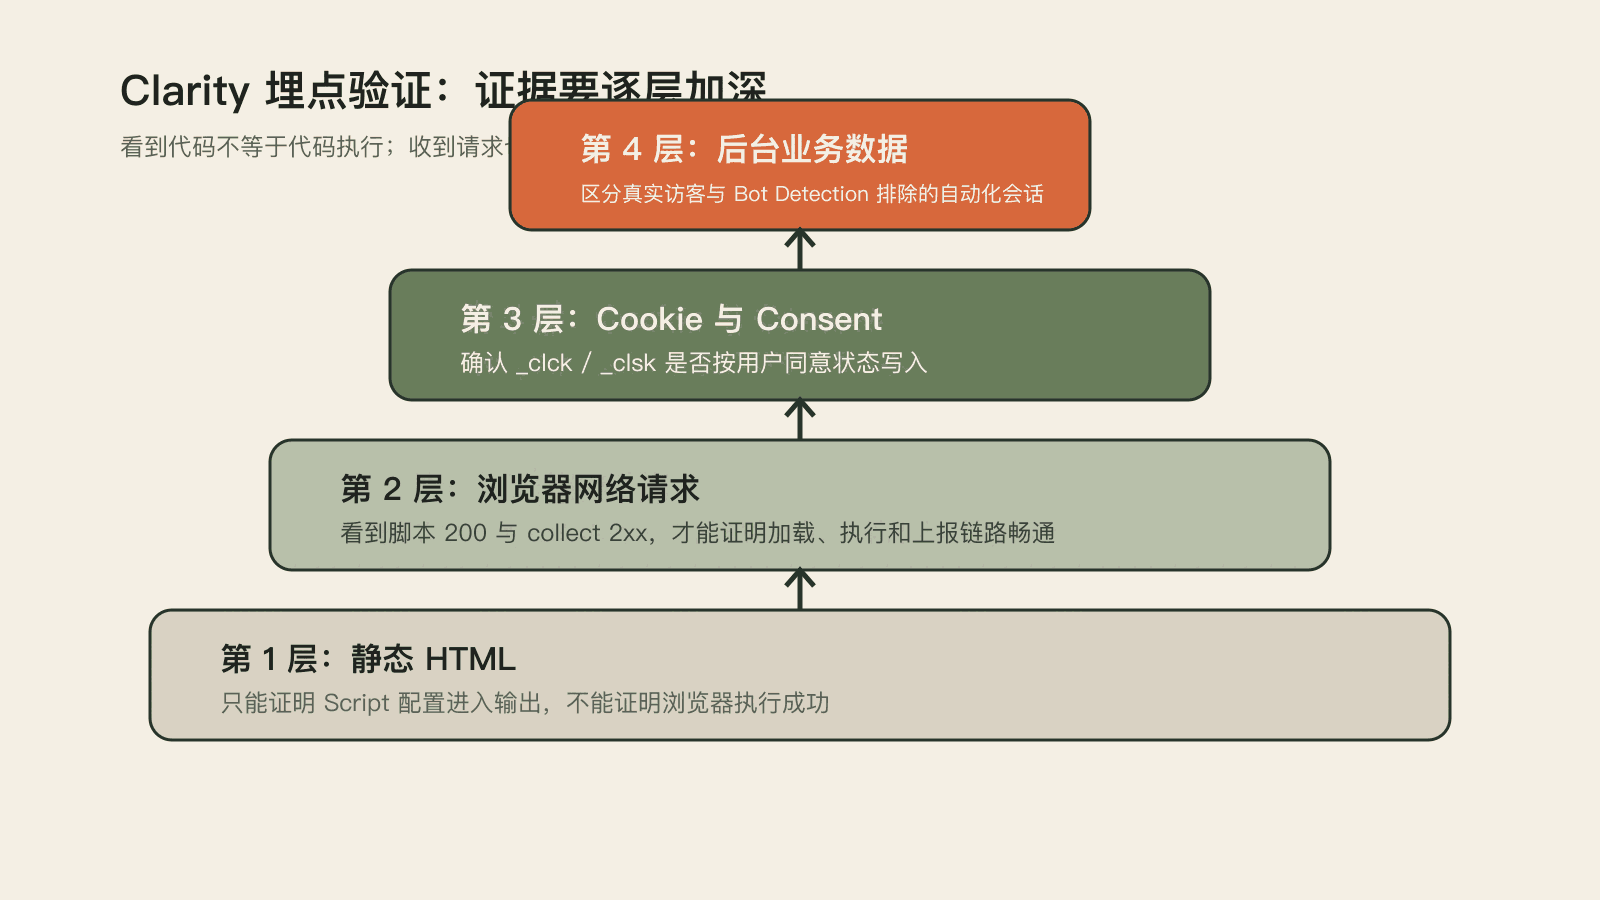
真正的验证需要浏览器网络层:
当时的实际输出中,Tag 与
clarity.js 返回 200,j.clarity.ms/collect 返回 204。这证明脚本完成了加载、执行与上报。但 Clarity 后台仍然没有普通会话。继续检查浏览器指纹后,原因才明确:自动化浏览器包含
HeadlessChrome,且 navigator.webdriver = true。Clarity 默认启用 Bot Detection,会把这类会话从普通统计中排除。这不是失败,而是两个验证目标被混在了一起:自动化浏览器可以证明技术链路畅通,却不能证明该会话会作为真实用户出现在业务面板。后台验收还需要一次普通浏览器访问,并等待数据处理完成。
分析 SDK 的隐藏代价:隐私政策会自动过期
接入 Clarity 后,原来声称“只使用严格必要 Cookie”和“分析数据经过聚合匿名”的隐私政策已经不准确。会话回放记录的是单个访问会话中的点击、滚动与鼠标移动,
_clck、_clsk 也属于分析用途,而不是登录所必需。这次对账还发现两个问题:
- 隐私政策写的是 Anthropic,但生产环境的 AI Provider 实际是 Gemini。
- 政策只写 Stripe,但新的结账入口已经切到 Creem;同时 Stripe 的 webhook 与 portal 仍服务历史订阅,不能简单删除 Stripe 条目。
正确处理不是机械地把旧厂商名称替换为新厂商,而是按真实数据流披露:谁当前接收用户数据,谁仍在处理历史数据,分别处理什么。
还有一个单改文案解决不了的边界:站点当时没有 Cookie Consent 机制。Microsoft 的 Consent Mode 文档要求站点先取得用户选择,再把状态传给 Clarity;对于 EEA、英国和瑞士的访问,自 2025 年 10 月 31 日起,有效 Consent 信号还关系到完整功能。
因此,接入第三方 SDK 的完成定义至少应包含:
- 代码与生产环境变量已经部署。
- 浏览器网络请求验证通过。
- Cookie 与 Consent 行为验证通过。
- 隐私政策和第三方服务清单已经对账。
- 自动化流量与真实用户数据在分析后台中被正确区分。
这套检查并不提供法律意见,但能避免最基本的事实错误。具体同意机制与适用法律仍应按目标市场咨询专业人士。
llms.txt 有用吗:可以部署,但不要把它写进核心 KPI
llms.txt 是放在站点根目录的文本约定,用于给愿意读取它的工具提供站点摘要与重点链接。它不是访问控制文件,也不是搜索引擎或大模型厂商共同确认的排名信号。ShotQuill 当前提供三类机器可读入口:
llms.txt:产品摘要与关键页面导航。
llms-full.txt:功能、用例、定价与 FAQ 等更完整信息。
index.md:首页内容的 Markdown 版本。
它们的工程价值是确定的:干净文本比带有样式、脚本和 RSC Payload 的 HTML 更容易被通用工具处理。但它们对主流 AI 引用率的增益没有可靠保证。Google 的官方指南甚至明确把不必要的 AI 文本文件列为可忽略的 GEO 技巧。
因此我的决策是:保留这些文件,因为生成和维护成本低;但不把它们当成核心增长动作,也不为目录站的付费加速审核支付费用。优先级更高的是可索引页面、第一手内容、准确实体信息、真实第三方提及与可持续测量。
index.md 还暴露了一个常见的命名误区。页面 <head> 中存在:这只是让客户端发现一个 Markdown 替代版本,不是 HTTP 内容协商。2026 年 9 月 21 日重新验证:
真正的内容协商需要服务端根据
Accept 头返回不同表示。是否值得实现,则应看目标爬虫是否真的发送该请求头;在没有证据时,不应为了“技术上更完整”增加中间件复杂度。结构化数据的边界:表达事实,不制造信誉
JSON-LD 的作用是把页面中的实体与属性用标准化结构表达出来。对软件产品,
SoftwareApplication 可以描述名称、应用类型、操作系统与价格等信息,但它不会自动带来富媒体结果,更不能把不存在的用户评价变成信誉。ShotQuill 的选择是保留真实价格的
Offer,不伪造 aggregateRating。Google 的软件应用结构化数据文档要求评分或评论字段对应真实可见内容,违规标记可能触发人工措施。判断一段结构化数据是否应该出现,可以用三个问题:
- 页面正文是否真的向用户展示同一事实?
- 值是否来自可维护的数据源,而不是手工复制后长期不更新?
- 删除这段标记后,产品事实是否仍然成立?
如果第三个问题的答案是否定的,说明你可能在用标记创造事实,而不是表达事实。
现场复核:旧结论必须让位于当前状态
2026 年 9 月 21 日,我重新请求了 ShotQuill 的公开入口。全部返回
200,但文件大小已经与前一天的记录不同:更重要的是,
robots.txt 的策略也发生了变化。旧素材记录的是“搜索与用户触发爬虫放行,训练类爬虫全禁”;当前线上版本已经把 OAI-SearchBot、GPTBot、Claude-SearchBot、ClaudeBot、CCBot、Google-Extended 等放进同一个允许组,只单独禁止 Bytespider。这意味着旧文章里“当前策略是拒绝训练爬虫”的说法已经失效。可验证的写法应该是:
- 当时曾采用过检索与训练分层的策略。
- 当前线上策略允许更多爬虫访问公开页面。
- 私有路径
/api/、/auth/、/dashboard、/editor/、/settings与/upgrade继续被禁止。
GEO 涉及的 UA 名单、产品能力与官方策略会变化。一次审计不是永久结论,文章也不应把时间点省略掉。
一份可以直接执行的顺序
如果从零给独立站补 GEO/SEO 基建,我会按下面的顺序做,而不是先去提交一批目录:
第一天:可抓取与可索引
- 确认主域、规范 URL、重定向与 GSC 属性类型。
- 提交 Sitemap,逐个验证关键 URL 的状态码与 Content-Type。
- 按目标明确配置
robots.txt,公开内容放行,登录态与产品内页禁止。
- 从 GSC 导入 Bing Webmaster Tools,并保留旧域属性观察迁移。
- 接入 IndexNow,但把成功标准定义为“通知被接受”,不是“保证收录”。
第二天:可理解与可引用
- 用一句话明确产品是什么、不是什么、服务谁。
- 把价格、功能、限制、支持范围与更新时间写成页面可见事实。
- 添加与页面内容一致的 JSON-LD,不伪造评分和评论。
- 低成本生成
llms.txt或 Markdown 入口,同时明确它不是排名保证。
第三天:可测量与可合规
- 打开 Bing AI Performance,记录引用页面与 grounding queries 的基线。
- 接入 Clarity 时限制 Production 环境,用浏览器网络请求验证执行与上报。
- 检查 Bot Detection,区分自动化验证与真实业务会话。
- 对账 Cookie、Consent、AI Provider、支付、存储与分析服务,更新隐私政策。
后续:用结果决定内容投入
- 哪些页面被索引,哪些没有。
- 哪些查询触发引用,引用了哪一页。
- 真实用户从哪个入口进入,又在哪一步离开。
- 哪些第三方提及产生了可观察的品牌搜索或推荐变化。
如果一个动作无法对应到这些问题中的任何一个,它很可能只是让清单变长,而没有让系统更可验证。
结论:GEO 的价值在证据链,不在文件数量
独立站 GEO/SEO 基建的结果,不应是“我装了多少工具、提交了多少目录”,而应是能够回答四个问题:谁可以抓取,哪些页面进入索引,什么内容被引用,用户到站后发生了什么。
ShotQuill 这次实践里,最有价值的不是新增了
llms.txt 或 Clarity,而是把判断标准从“代码里有”推进到“浏览器真的执行”,再推进到“后台为什么没有业务数据”,最后检查“这项接入让哪些隐私承诺失效”。llms.txt 可以保留,IndexNow 值得接入,Bing AI Performance 值得持续看,Clarity 也能帮助定位转化问题。但它们都不是独立生效的 GEO 开关。可抓取、可索引、可引用、可测量、可合规,缺一层,后面的结论都可能失真。参考资料
- Google's Guide to Optimizing for Generative AI Features on Google Search,Google Search Central
- Consent Mode,Microsoft Clarity
如果你也在给独立站做 GEO/SEO,欢迎在评论区分享你验证过的收录、引用或埋点问题。具体的失败证据比泛泛的成功经验更有价值,也可能帮海内外开发者少走一遍弯路。
关注沐风,不定期更新,全是干货。
2026.09.21 20:14
沪 · 赵巷