AI 宣传视频制作:从真实截图到六支双语成片
type
status
date
slug
summary
tags
category
icon
password
wechat_gate
AI 宣传视频制作,最容易低估的是声音、画面和字幕之间的约束。PDFMesa 的实践采用真实截图、脚本生成分镜、自动操作剪映的方式,完成中英文各 30 秒、1 分钟、3 分钟六支成片。但初版技术检查通过,回听仍被指出“太机器化”。这次返工,比一键成片更值得分析。
AI 宣传视频制作,先把产品事实变成分镜
PDFMesa 是一款原生 macOS PDF 应用。这套方法属于自动化剪辑流水线:输入是产品事实、真实截图和文案,输出是可验证的多版本视频,画面没有交给生成模型重绘。
宣传片需要展示真实行为。左右对照不能写成“自动识别差异”;离线阅读编辑不代表购买也不联网;自动保存会写入原文件,需要保留原件就应先另存副本。功能边界必须进入文案,编码参数无法纠正宣传错误。
项目已有中英文演示截图,来自真实 Debug 窗口。演示构建开启了 Pro 功能,能证明界面存在,不能证明购买流程已经验收。笔记卡是排版示意,也没有冒充实际导出窗口。
六支片子按任务拆分:每种语言的短版 6 镜建立印象,中版 8 镜串联工作流,长版 18 镜解释保存、对照和文档限制,共 64 段。英文按表达目的重写,界面、标题、旁白和字幕分别处理,避免把中文长度直接套给英文。
同一份分镜数据,控制素材与时间
手工剪六个版本,改一句旁白就可能牵动镜头、字幕和配乐。项目把每镜的画面类型、标题、辅助文字、旁白和付费标记放进同一份内容数据,再生成各类素材。
Python 组织数据,Pillow 负责图片排版,FFmpeg 负责音视频合成。每镜输出一段已经包含声音与字幕的视频。Computer Use,即观察屏幕后操作应用的自动化代理,负责在剪映导入、排序、创建时间线和正式导出。
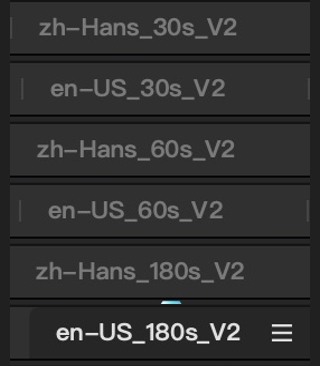
原始剪映截图的局部阅读版:将六条版本时间线页签分六行排列,未改写界面文字。
关键约束是时间累加:某镜头的全片起点,等于它之前所有镜头时长之和。字幕偏移、配乐截取和音轨核查都使用这个起点,减少各自维护时间表造成的漂移。
预合成降低了对剪映内部草稿格式的依赖,但文字、配音和字幕已经进入视频,不能在剪映里逐字编辑。频繁改稿时,需要保留分离源文件并重建镜头;这套取舍更适合版式稳定、需要批量导出的项目。
配音机器感:先给自然语音留出时间
初版先固定镜长,再把过长旁白压进去。macOS 系统语音的部分段落被加速,最大约 1.412 倍。两支长版共 36 段,其中 23 段超过 1.15 倍;这个分界只是统计口径,不是自然度标准。
“太机器化”是实际反馈。系统音色、书面枚举、时间压缩和跨段语气都可能有影响,但没有受控试听,不能认定其中某一项是唯一原因。
V2 改用 ListenHub 的文字转语音,中文选“原野”,英文选 Mars,使用直接朗读模式、原速合成。每镜保留完整语义段落,超时就删改文案。首次中文长版的源音频合计约 180.648 秒,连额外停顿都放不下,因此两种语言合计删改重录了 14 段。
自然语音、观察时间和总片长共同竞争同一个预算。 在不加速的前提下,文案过长只能通过删减信息或延长成片解决。更换音色不会改变这个约束。
项目在 30 帧每秒下,为每镜预留 0.3 秒开口前停留及至少 0.4 秒镜尾余量。最低帧数等于“语音秒数乘 30,向上取整,再加 21”。总片长扣除这些最低帧数后,才分配额外观察时间;剩余为负就停止生成。
复杂的对照、整理画面获得更多余量。这是剪辑经验权重,没有观众认知实验支持,不能包装成科学最优参数。
V2 版本 | 源旁白合计 | 额外镜头停留 |
中文 30 秒 | 17.64 秒 | 12.36 秒 |
英文 30 秒 | 16.06 秒 | 13.94 秒 |
中文 60 秒 | 45.61 秒 | 14.39 秒 |
英文 60 秒 | 42.01 秒 | 17.99 秒 |
中文 180 秒 | 154.55 秒 | 25.45 秒 |
英文 180 秒 | 152.10 秒 | 27.90 秒 |
源旁白包含音频内部停顿,“额外停留”不是全片静音统计。V2 全部 64 段未作时间拉伸,但跨段语气、专有名词发音和最终自然度仍需人工试听。
音频总长正确,为什么还会错位
V2 曾出现另一类故障:混音后的首个 AAC(常见音频编码)音频包持续约 0.310667 秒,后续常规包约 0.021333 秒,开头存在约 0.29 秒不连续,进入剪映后造成旁白起点偏移。
媒体文件除了采样内容,还保存“何时播放”的时间戳。总时长相同,只说明终点接近,不能保证中间每个声音落在正确位置。普通减去首时间戳只能移动起点,不能消除内部空档。
项目在响度处理后先统一采样率、重置起点,再加入真实的开头停留;混音尾端还按累计采样数重建时间戳,使声音沿连续的采样时间排列。这里修正的是时间基准,不能拿来替代文案节奏调整。FFmpeg 滤镜文档说明了相关时间戳与重采样机制。
修复后首包恢复到约 0.021333 秒,64 段重建,再从剪映重新导出。最终文件为 44.1 kHz,中间素材为 48 kHz;报告应以各自实际文件为准。
验收必须分开回答“没出错”和“好不好”
V2 六支成片记录均为 1920×1080、30 帧每秒,时长分别精确到 30、60、180 秒,并通过完整解码。技术验收分三层:
- 文件层:核对时长、编码和完整解码,排查损坏与错误导出。
- 对照层:逐镜抽取中点画面对照源片段,检查顺序;比较对应音轨,排查错声音和明显偏移。
- 体验层:人工检查切点、小屏字幕、读音、停顿和跨段语气。
音轨比较也会误报。英文中版一镜的原始相关性约 0.8955,校正一个采样点后约 0.9882。项目只允许在正负 1 毫秒内寻找匹配,避免放任偏移掩盖同步问题。这项检查证明音轨对应关系,不能证明配音动听。
字幕同样有边界:V2 先估计有声区间,再按文本长度分配时间。这不是逐词识别或精确对齐;字幕不越界,也不等于每句同步。平均电平和采样峰值检查,也不能冒充最终综合响度与真峰值验收。
操作代理还必须观察导出后页面。项目曾出现平台上传及登录界面,随后关闭,没有确认公开发布;因此只能报告本地导出,不能声称全过程未上传。
从一个短样片开始,控制返工成本
第一次搭建,可以按以下顺序推进:
- 准备一组真实截图、一个明确卖点和口语稿,核对功能及授权边界。
- 用实际品牌词生成一段短样音,记录音色、文本、参数和时长,先听纯人声再听混音。
- 制作一个短版,按语音长度分配镜头;超时先改稿,保留独立旁白和字幕。
- 在剪映完成一次组装导出,再独立核查实际文件。这个闭环成立后,才扩展语言和时长。
ListenHub 的直接朗读模式适合准备好的单人稿件,具体入口见其官方 TTS 指南。换服务时要重新试音,不能把另一家模型的停顿标签直接照搬。ElevenLabs 的指导也区分了模型对停顿和发音控制的支持。
这套流水线减少了重复排版和多版本组装,却没有取消剪辑判断。适合先自动化的是确定的尺寸、顺序和时间计算;应留给人工的是产品表达、声音表演与观看体验。先让一个短样片讲清楚,再让流水线复制它的结构。
参考资料
2026.11.02 22:22
沪 · 赵巷
写 AI,写成长,偶尔写投资。
关注沐风,不定期更新,全是干货。